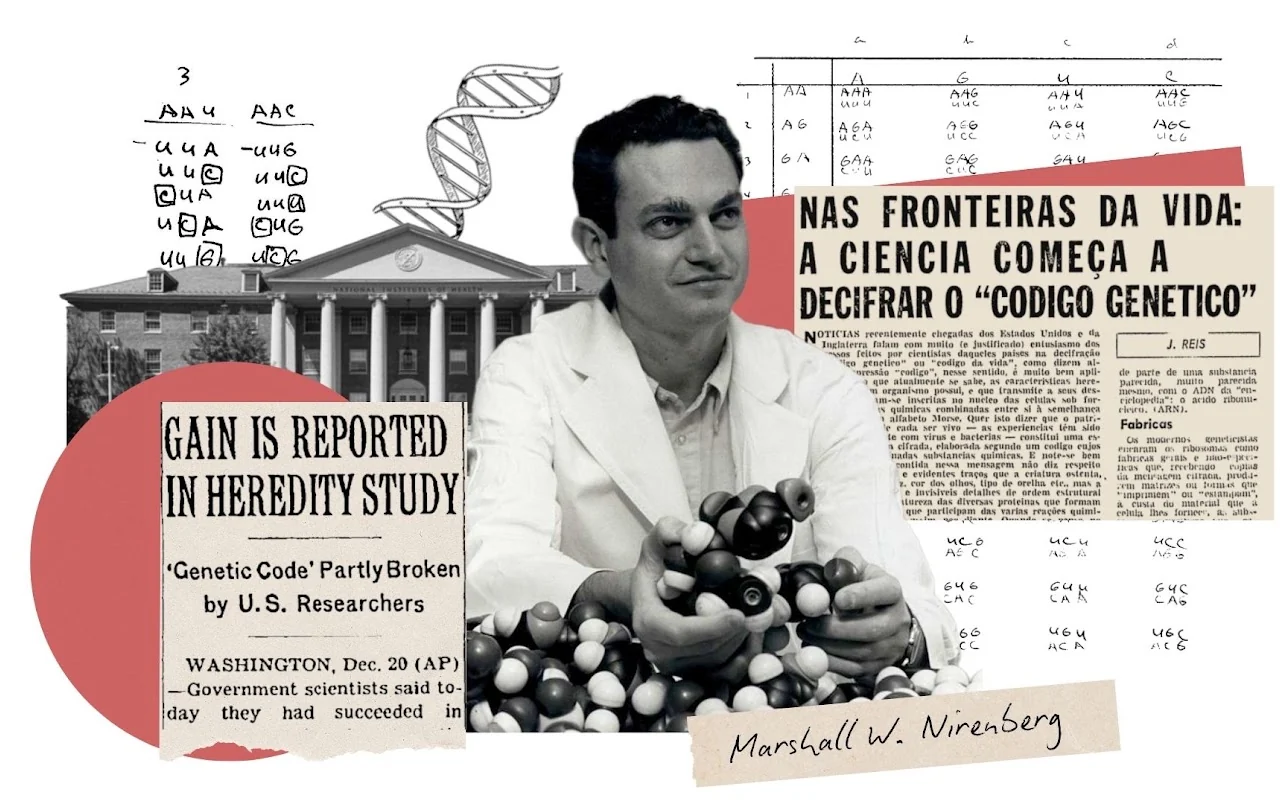
Poucas descobertas científicas transformaram tanto a compreensão da vida quanto o código genético. Mais de meio século após sua decifração, essa conquista da biologia molecular continua, paradoxalmente, sendo mal interpretada pela mídia e pelo público. Um equívoco persistente que confunde o código genético, um conjunto de regras válido para quase todos os seres vivos, com o genoma, a sequência única de DNA de cada organismo.
Nos anos 1960, a biologia vivia um de seus momentos mais eletrizantes. Após a dupla hélice do DNA ser revelada em 1953, restava o grande enigma: como, exatamente, a informação genética é traduzida em proteínas? Era o elo que faltava entre o gene e a vida.
Do DNA à proteína
O DNA é a molécula que carrega a informação genética responsável pelo desenvolvimento e funcionamento de um organismo. Ele é composto por duas cadeias ligadas entre si que se enrolam formando uma estrutura semelhante a uma escada torcida — a famosa dupla hélice.
Essa molécula é construída por nucleotídeos, cada um formado por um açúcar-fosfato ligado a uma base nitrogenada. Os “degraus” da escada do DNA correspondem aos pares de bases: adenina (A) com timina (T) e guanina (G) com citosina (C).
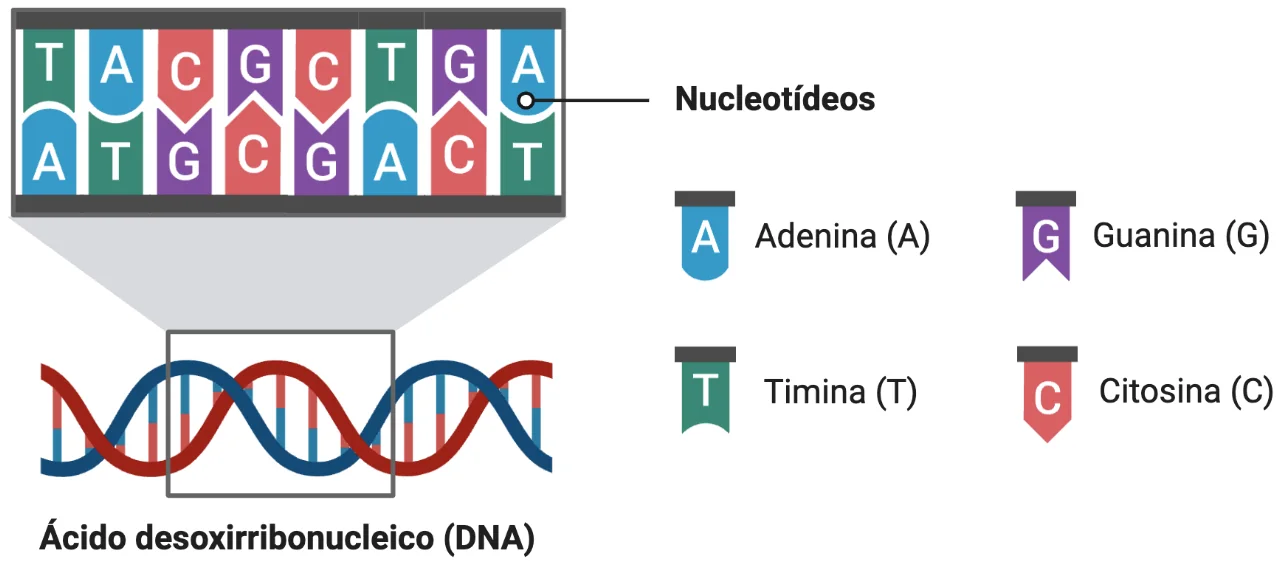
A informação contida no DNA é “lida” como uma receita para a produção de proteínas. Esse processo ocorre em duas etapas. Na transcrição, trechos específicos do DNA servem de molde para a formação do RNA mensageiro (mRNA). Em seguida, na tradução, o mRNA orienta a síntese das proteínas.
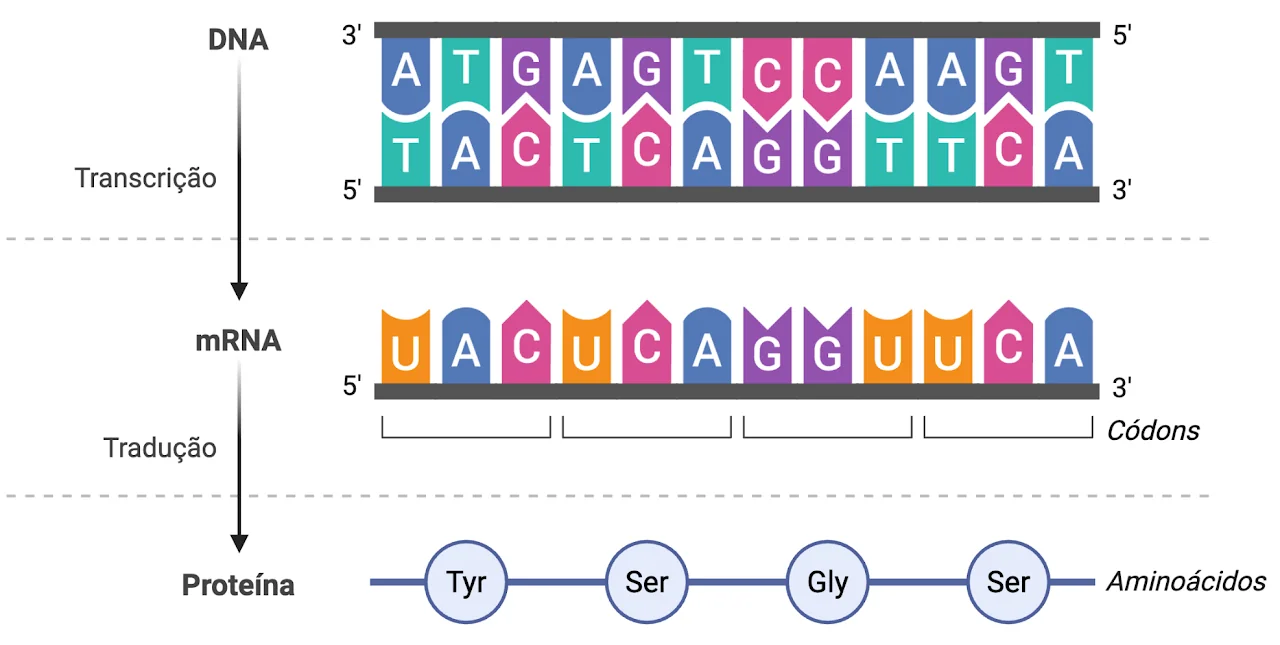
As proteínas são moléculas complexas que desempenham funções importantes no organismo. Elas são compostas por aminoácidos.
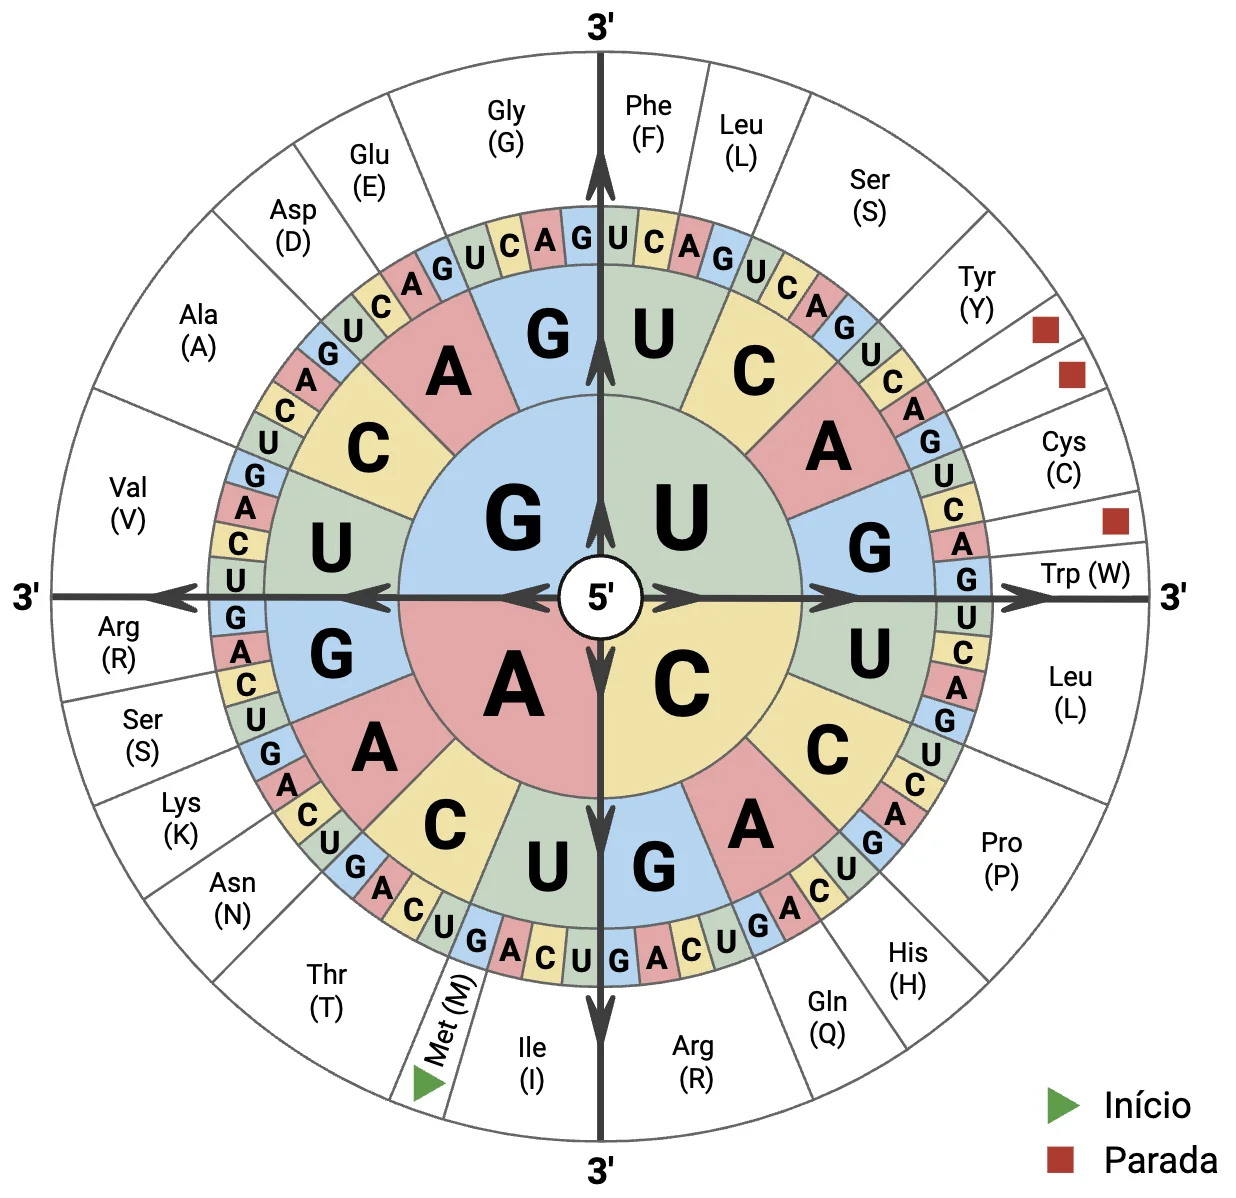
O código genético é, essencialmente, um dicionário de tradução entre duas linguagens químicas. Ele define como a sequência de quatro bases nitrogenadas — adenina (A), uracila (U), citosina (C) e guanina (G) — é convertida na sequência de 20 aminoácidos que formam as proteínas.
A leitura ocorre em grupos de três bases consecutivas, chamados códons (como AUG ou UUU). Há 64 códons possíveis, cada um correspondendo a um aminoácido específico ou a um sinal de “início” ou “parada” da tradução. É essa linguagem quase universal que permite a passagem da informação genética à função biológica.
O código genético
Descoberta
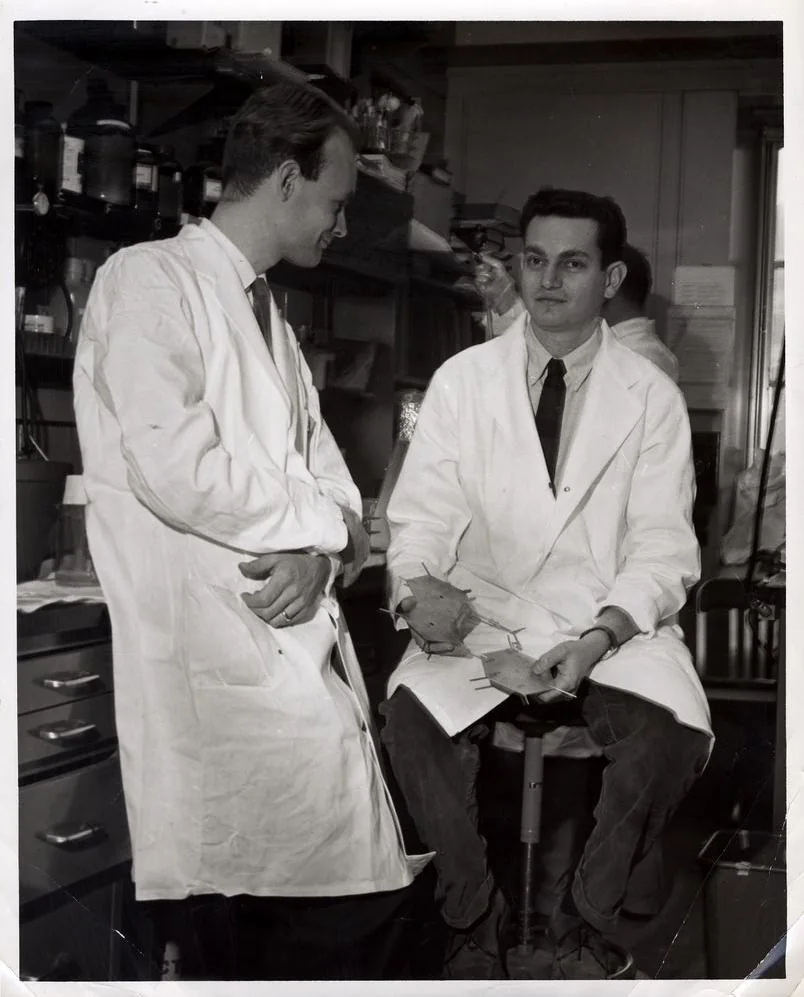
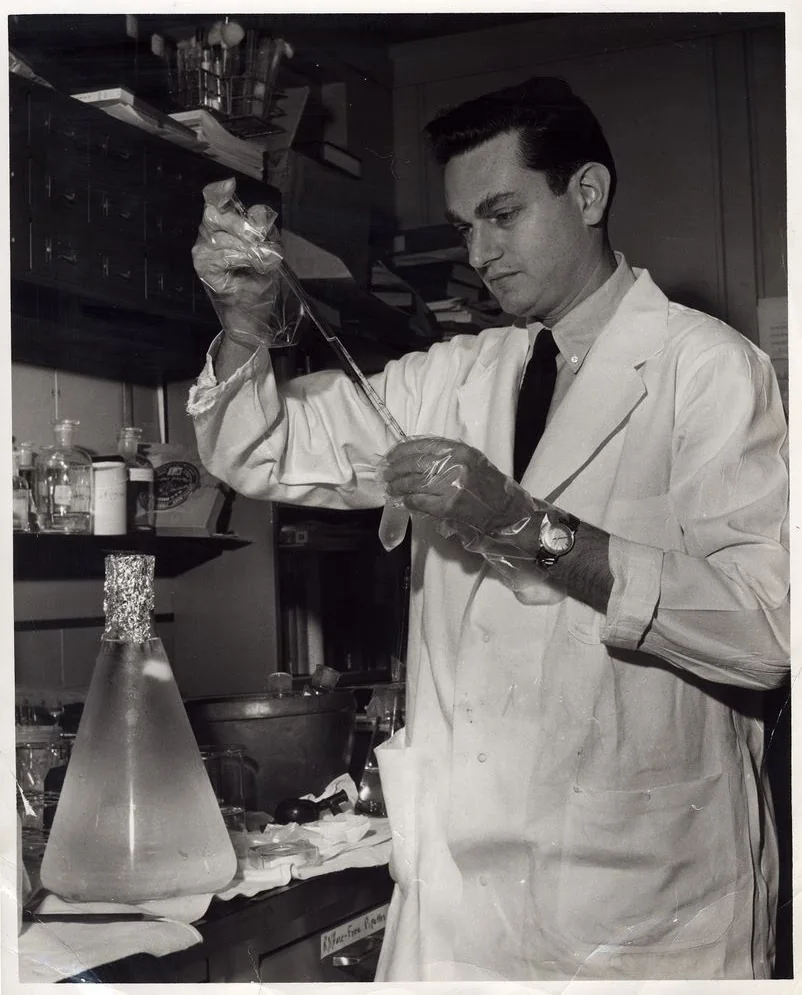
A primeira chave para decifrar esse sistema foi girada em 1961, no Instituto Nacional de Saúde dos Estados Unidos, por Marshall Nirenberg (1927–2010) e Heinrich Matthaei (1929–2025). Eles sintetizaram uma fita de RNA composta apenas pela base uracila — o chamado poly-U — e a adicionaram a um extrato celular. O resultado foi a produção de uma proteína formada exclusivamente por fenilalanina, revelando a primeira correspondência do código: UUU → fenilalanina.
A descoberta desencadeou uma verdadeira corrida científica. Nos anos seguintes, o código foi sendo desvendado códon por códon, até ser completamente decifrado em 1966. Era o início da biologia molecular moderna e, com ela, o nascimento de uma nova linguagem para falar sobre a vida.
- 1944o dna é reconhecido como o material da herança biológica em experimento com pneumococos
- 1952experimento com vírus confirma o papel do dna
- 1953descoberta da estrutura de dupla hélice do dna
- 1961marshall nirenberg e heinrich matthaei realizam o experimento do poly-u, mostrando que o códon uuu codifica o aminoácido fenilalanina
- 1966o código genético é completamente decifrado
- 1968nirenberg, khorana e holley ganham o prêmio nobel
- 1979descobertas as primeiras exceções: o código mitocondrial humano e de leveduras mostra pequenas variações
Euforia e os temores da época
A imprensa reagiu com entusiasmo quase messiânico. Em janeiro de 1962, José Reis escreveu na Folha de São Paulo, em tom elogioso e entusiasmado, que a descoberta abria as portas para “a receita de fabricação de um ser vivo”.
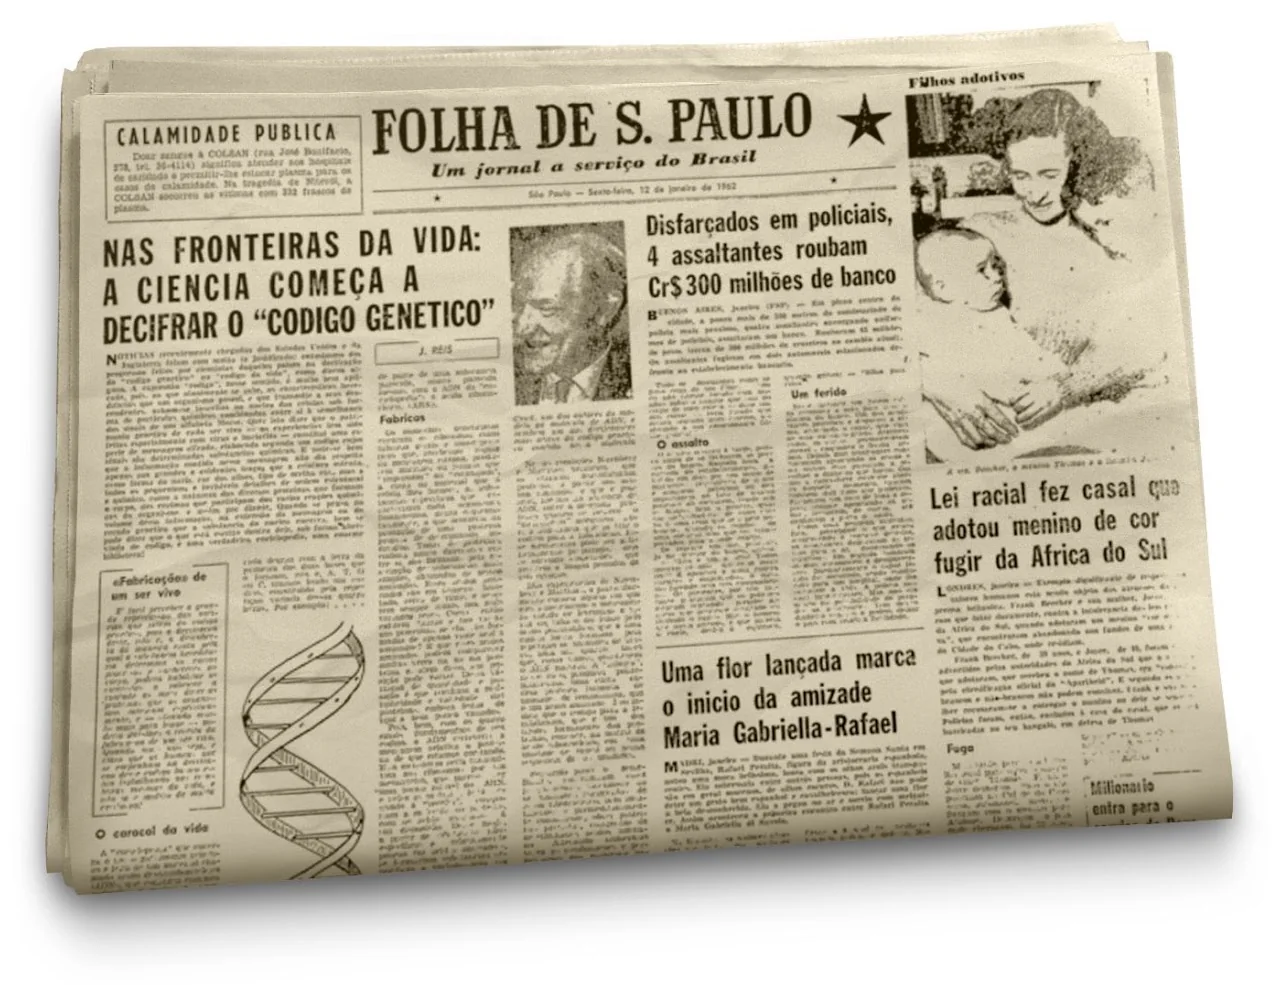
No exterior, em fevereiro do mesmo ano, o New York Times descreveu uma “revolução cujo significado e magnitude só se tornaram aparentes nas últimas semanas”. O jornal relatava um clima de descoberta tão intenso que “muitos cientistas mal conseguiam compreender o potencial do barril de pólvora em que estavam sentados”. As promessas eram grandiosas: curar doenças incuráveis, controlar a hereditariedade e, até mesmo, “criar vida” em laboratório e compreender a base do pensamento.
Parte desse imaginário vinha de uma ideia bastante presente na época: a crença de que a memória poderia estar armazenada em moléculas como o RNA. Experimentos controversos sugeriam — erroneamente, como se sabe hoje — que a memória poderia ser transferida como informação química. Nesse contexto, a decifração do código genético fez muitos acreditarem que seria possível, em seguida, decifrar e até manipular um suposto “código da mente”.
O prêmio Nobel Arne Tiselius advertiu, em uma matéria do mesmo jornal em janeiro de 1962, que, se mal utilizada, essa nova ciência poderia levar à “criação de novas doenças, ao controle das mentes e da hereditariedade” — uma nova forma de manipular a vida mais perigosa do que os próprios instrumentos de destruição em massa.
Essa mistura de fascínio e temor moldou a forma como o público passou a compreender o código genético: uma metáfora poderosa que, nas décadas seguintes, seria estendida a vários aspectos da biologia. No entanto, ao mesmo tempo em que elevou a genética ao imaginário popular, essa linguagem também pavimentou o caminho para uma confusão conceitual que perdura até hoje.
Distorção do sentido
Apesar de o conceito de Código Genético estar bem estabelecido na biologia — o conjunto de regras que define como trincas de nucleotídeos (códons) são traduzidas em aminoácidos —, a divulgação e o jornalismo científicos insistem em um equívoco que atravessa décadas: confundir o código genético com o genoma ou com a sequência de DNA.
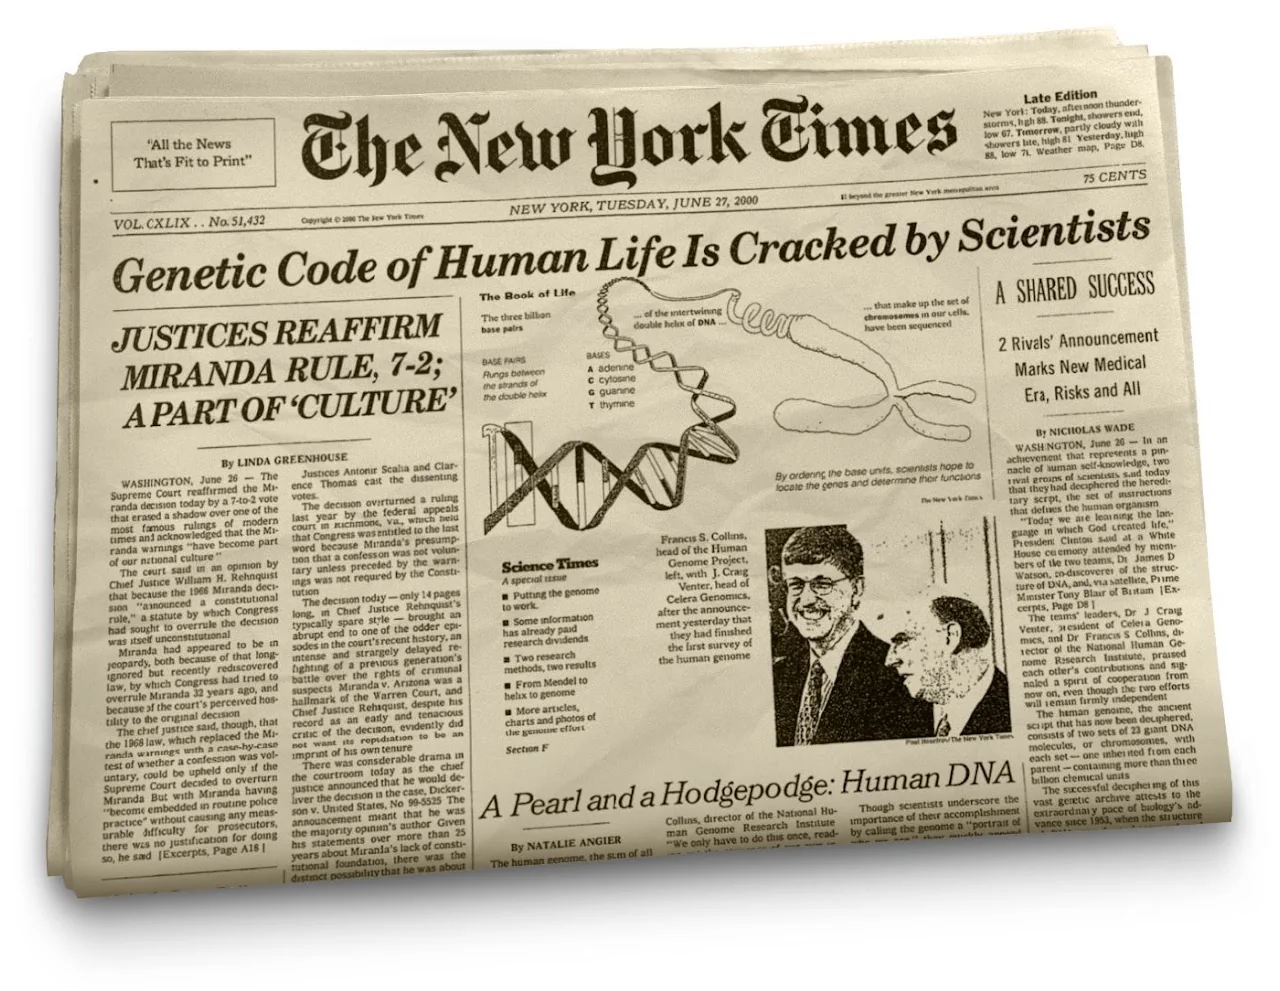
Essa confusão ganhou força sobretudo com o Projeto Genoma Humano, cujos resultados foram anunciados com euforia no ano 2000. O New York Times (27/06/2000) estampou que “o código genético da vida humana é decifrado por cientistas”; a Folha de S. Paulo proclamou que a “Ciência decifra código genético”, e o Jornal do Brasil classificou o feito como “um passo fundamental para a leitura do código genético”. Nenhuma dessas reportagens se referia, de fato, ao código que rege a tradução de códons em aminoácidos — decifrado desde 1966 —, mas sim à sequência de bases do genoma humano. Desde então, o uso de “código genético” como sinônimo de genoma se espalhou e está presente até os dias de hoje.
O código genético é considerado universal porque, com raras exceções, todos os organismos vivos — das bactérias aos seres humanos — utilizam as mesmas combinações de códons para designar os mesmos aminoácidos. Essa regularidade é uma prova da ancestralidade comum da vida na Terra.
Ao falar em “código genético humano” ao invés de “genoma humano”, a mídia apaga justamente o aspecto mais notável dessa descoberta: o de que a gramática molecular da vida é compartilhada por quase todos os seres vivos. O genoma — a sequência específica de nucleotídeos no DNA de cada um — nos torna singulares; o código, ao contrário, é o que nos conecta a todas as formas de vida conhecidas.
A universalidade do código genético raramente recebeu destaque na grande mídia. Nos anos que se seguiram à sua decifração, as reportagens concentravam-se no feito técnico e em suas possíveis aplicações médicas. Nas décadas seguintes, a expressão “código genético” passou a ser usada de forma imprecisa em matérias sobre sequenciamento genético, variações individuais, transgênicos e engenharia genética, distanciando-se do sentido original. Só mais recentemente, com o avanço da biologia sintética, o termo voltou a aparecer em contextos que de fato envolvem a modificação das regras do código.
Metáfora da linguagem
Desde o início da biologia molecular, a genética tem sido explicada por metáforas de linguagem e código. Em What is Life? (1944), o físico Erwin Schrödinger foi um dos primeiros a sugerir que a hereditariedade dependia de um “code-script” — um roteiro molecular que guiaria o desenvolvimento dos organismos. A ideia de uma mensagem escrita na matéria viva tornou-se central nas metáforas que marcaram tanto a ciência quanto sua divulgação.
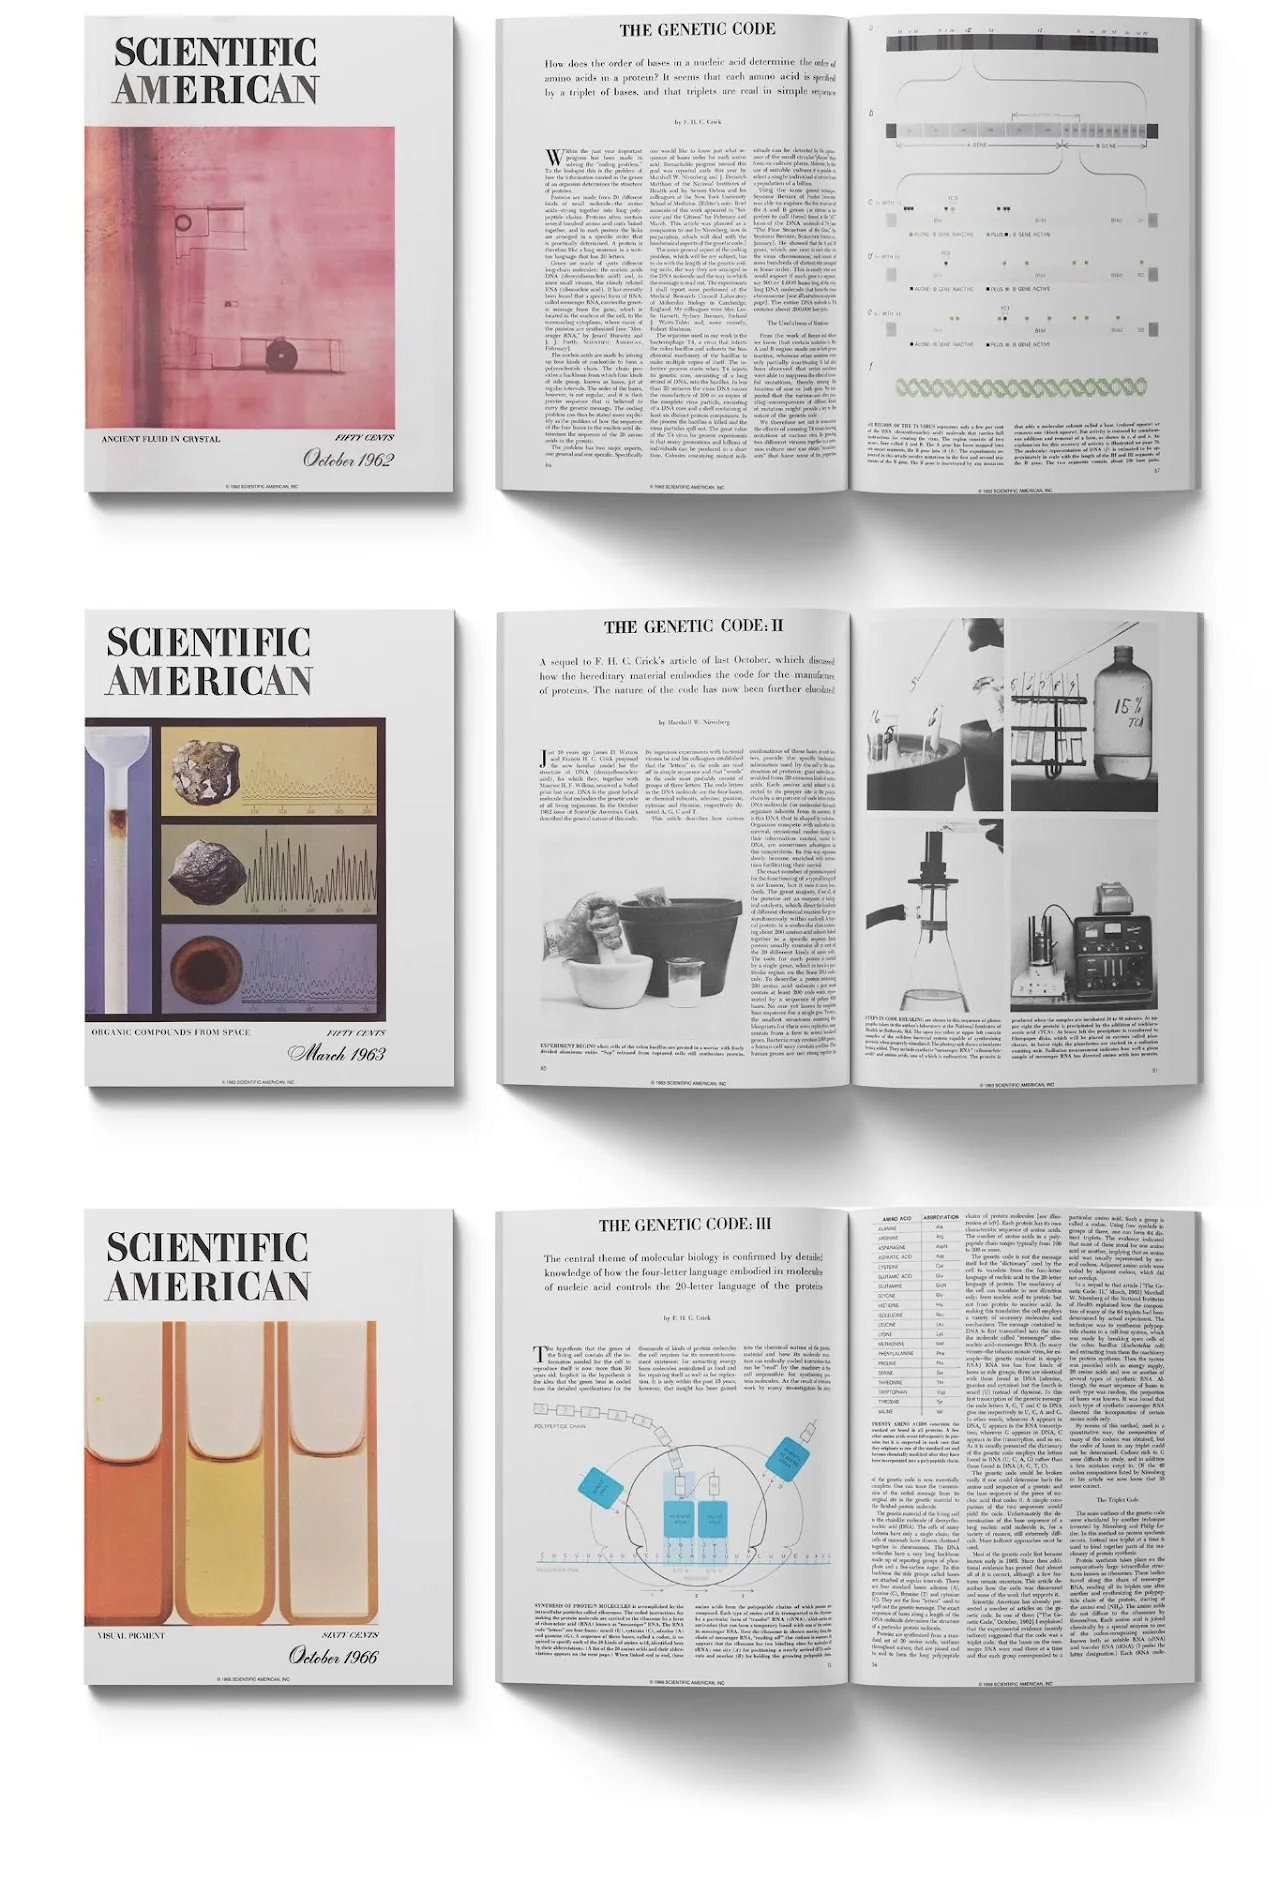
Nas décadas seguintes, o DNA passou a ser descrito como uma forma de escrita biológica. Uma trilogia de artigos publicada na Scientific American em 1962, 1963 e 1966, assinada por Francis Crick e Marshall Nirenberg, consolidou esse vocabulário: “alfabeto químico”, “mensagens”, “leitura”, “tradução” e um “dicionário” molecular capaz de converter a linguagem dos genes na das proteínas. Com o tempo, expressões como “código genético”, “livro da vida”, “edição genética” e comparações com o código Morse se espalharam por livros e reportagens.
Essas metáforas facilitaram a compreensão de um campo altamente técnico, mas também abriram espaço para equívocos. A geneticista Regina Célia Mingroni-Netto, professora da USP, defende o uso de metáforas na educação — desde que coerentes e bem contextualizadas. Na divulgação científica, o desafio é equilibrar clareza e precisão.
Quando esse equilíbrio falha, algumas confusões conceituais são difíceis de serem abandonadas. Mingroni-Netto conta que mesmo alguns alunos na pós-graduação continuam repercutindo esse imbróglio terminológico entre código genético e genoma. Ao menos em parte, essa confusão parece vir da mídia.
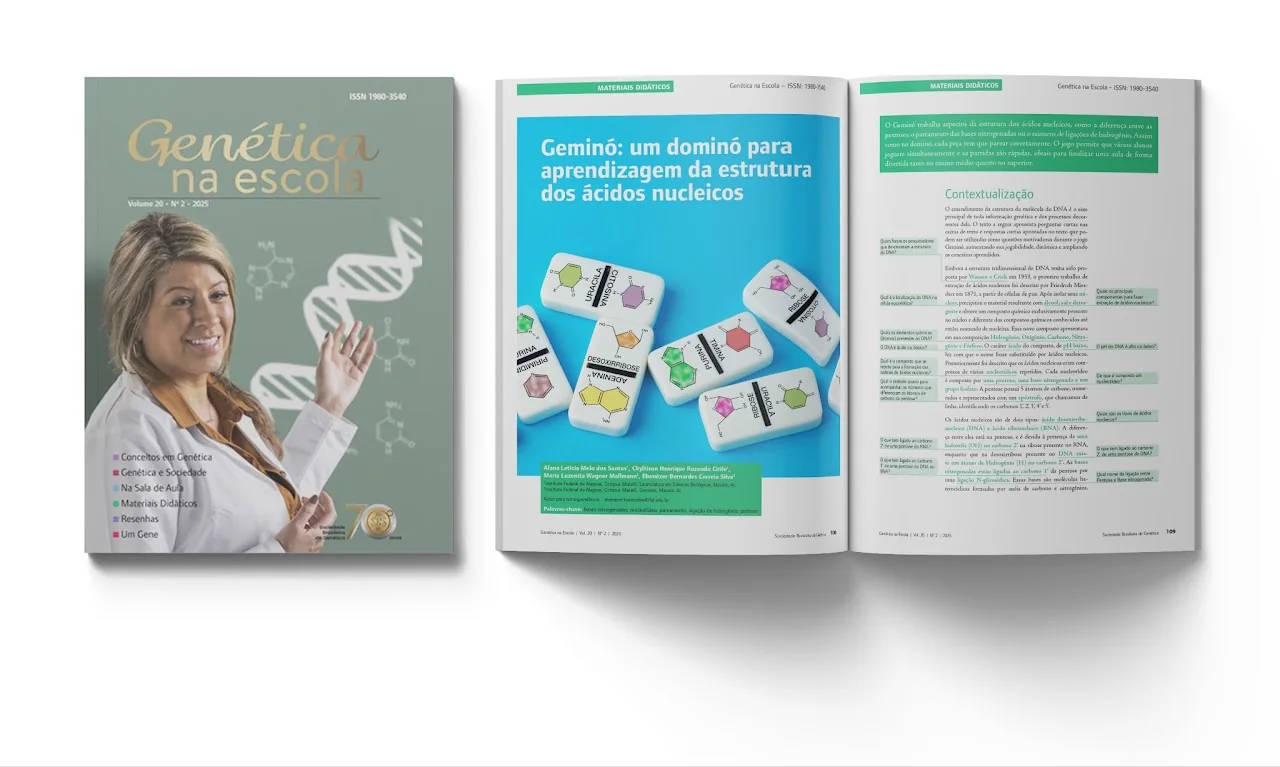
É nesse ponto que entra a importância da divulgação criteriosa. Mingroni-Netto é editora-chefe da Genética na Escola, uma revista que busca atualizar professores da educação básica em temas recentes, oferecendo materiais e atividades que traduzem conceitos complexos sem perder rigor. A publicação não é uma revista de divulgação científica tradicional, mas cumpre função semelhante ao popularizar termos e noções da área.
Essa proposta traz desafios conhecidos: grande parte dos autores é formada por acadêmicos de genética, o que exige atenção redobrada para evitar jargões excessivos e garantir metáforas precisas. “Os manuscritos submetidos iam e vinham muitas vezes até que o texto estivesse minimamente dentro do esperado para os padrões da revista” conta a professora da USP Eliana Dessen, que foi editora da revista por 13 anos.
Para Dessen, a imprecisão nesses conceitos de genética pode causar mais ou menos confusões a depender de quem lê. Se, por exemplo, um vestibulando “for influenciado por reportagens não precisas, que usam de forma errônea os conceitos, ele errará a questão na prova”. Ao mesmo tempo, “para o grande público, às vezes é mais importante ler e conversar sobre o tema para se familiarizar”. Mas, explica a professora, talvez não seja possível separar perfeitamente esses dois públicos.
Mas quão importante é, afinal, essa confusão terminológica?
O debate sobre o uso correto da terminologia genética não é a única preocupação de Mingroni-Netto. Ela cita também os equívocos recorrentes da mídia e do público relacionados ao “determinismo genético”: a ideia de que “tudo o que está escrito no DNA é inexorável, imutável, que nada pode fugir ao que o DNA determina”.
Essa também é uma das principais preocupações de Ana Arnt, professora da Unicamp que trabalha com ensino e divulgação de biologia. Para ela, a noção de que os genes definem de forma fixa características humanas — sem considerar ambiente, história ou possibilidade de mudança — é uma das ideias mais perniciosas na divulgação científica. E, na maior parte das vezes, simplesmente incorreta. “Isso tem um efeito muito grande quando pensamos em condições genéticas associadas à saúde, em questões estéticas ou em atributos socialmente hierarquizados, como gênero, raça e etnia”, explica. No fim das contas, essa tendência da mídia em tratar temas de genética — particularmente sobre o genoma humano, mesmo quando o chama de “código genético” — de forma determinista acaba por reforçar estereótipos de gênero e étnicos.
Apesar dessa preocupação conjunta com o determinismo genético na mídia, Arnt relativiza o debate sobre o rigor terminológico. Segundo ela, “a função do jornalismo e da divulgação científica não é ter o mesmo rigor de um artigo acadêmico, porque não fala para o mesmo público”. Nesse sentido, “o rigor está mais na informação correta, nos pressupostos éticos do jornalismo e da divulgação científica” — como evitar justamente a reafirmação de visões deterministas.
Para Arnt, vale a pena insistir em definições estritas apenas quando essa diferenciação é essencial para o leitor compreender o tema. “O rigor tem mais a ver com o quanto o nosso público precisa de determinadas informações para entender o contexto”, afirma. Caso contrário, introduzir jargões excessivamente precisos pode não alterar o sentido da informação — só torná-la menos acessível.
A precisão vocabular, portanto, mantém seu valor, como mostra a própria história da divulgação sobre o código genético. Mas, para Arnt, certas questões éticas se sobrepõem: o mais importante é garantir que a divulgação científica não perpetue mitos — especialmente aqueles ligados ao determinismo genético.
Renato Brocchi é formado em história pela Unicamp e jornalismo pela Universidade de São Paulo. Cursa especialização em jornalismo científico (Labjor/Unicamp).
Thabata Oliveira é formada em ciências biológicas e em design pela Universidade de São Paulo. É ilustradora e cursa especialização em jornalismo científico (Labjor/Unicamp).